Latem 2026 roku liczba udokumentowanych przypadków deepfake na świecie sięgnęła kilku milionów rocznie — wzrost o około 900% w ciągu zaledwie dwóch lat. Jednocześnie badanie przeprowadzone przez Microsoft na próbie 12 500 osób, obejmujące niemal 287 000 ocen obrazów wygenerowanych przez DALL·E 3, Midjourney v6 i Stable Diffusion 3, wykazało coś otrzeźwiającego: ludzie poprawnie rozpoznają, czy zdjęcie jest dziełem AI, tylko w 62% przypadków — ledwie powyżej rzutu monetą. W przypadku twarzy generowanych sieciami GAN i zdjęć edytowanych metodą inpaintingu skuteczność rozpoznawania spadała poniżej 50%, czyli gorzej niż przypadkowe zgadywanie.
Ten artykuł to kompletny, techniczny protokół weryfikacji treści cyfrowych pod kątem AI — zdjęć, wideo, audio i tekstu. Zamiast kolejnej listy „7 sygnałów, po których poznasz AI” (które, jak pokazują dane wyżej, ludzki mózg i tak stosuje ze skutecznością zbliżoną do losowej), proponuję metodologię opartą na trzech niezależnych warstwach weryfikacji, wspieraną konkretnymi narzędziami, z których część jest darmowa i dostępna dla każdego.
Dlaczego „patrzenie na palce” już nie wystarcza
Jeszcze do niedawna generatory AI zdradzały się charakterystycznymi błędami: nienaturalną liczbą palców, rozjeżdżającą się geometrią napisów, dziwną symetrią twarzy. W 2026 roku te sygnały praktycznie zniknęły z najnowszych modeli — a mimo to wiele poradników wciąż powtarza te same, przestarzałe wskazówki. Rzetelne źródła branżowe wprost przyznają: „w materiałach AI nie ma już sześciu palców ani rozjeżdżonej geometrii” — jakąś intuicyjną „czujkę” da się jeszcze wyczuć, ale bez narzędzi technicznych coraz trudniej ją zweryfikować.
To dlatego poleganie wyłącznie na analizie wzrokowej to dziś najsłabsza z dostępnych metod weryfikacji — nie najsilniejsza, jak sugerują popularne poradniki.
Protokół trzech warstw weryfikacji
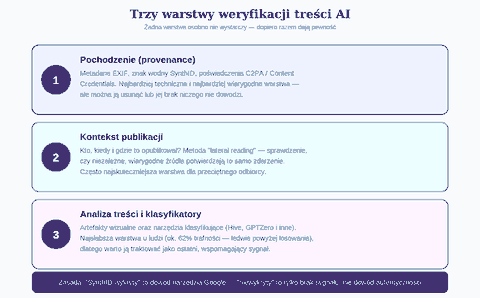
Profesjonaliści zajmujący się weryfikacją treści (OSINT, dziennikarstwo śledcze, cyberbezpieczeństwo) zalecają sprawdzanie trzech niezależnych, wzajemnie uzupełniających się warstw dowodowych. Żadna z nich osobno nie daje pewności — dopiero ich zestawienie pozwala wyciągnąć wiarygodny wniosek.
Warstwa 1: pochodzenie (provenance)
Pierwszy krok to sprawdzenie technicznego „rodowodu” pliku — metadanych, znaków wodnych i cyfrowych poświadczeń.
Metadane EXIF. Każde zdjęcie z aparatu lub telefonu domyślnie zawiera metadane: model urządzenia, datę, ustawienia obiektywu. Plik „prosto z aparatu”, który nosi ślady eksportu z generatora AI, wymaga wyjaśnienia. Trzeba jednak pamiętać: brak metadanych EXIF nie jest dowodem na AI — większość serwisów społecznościowych rutynowo czyści te dane przy wgrywaniu, niezależnie od pochodzenia pliku.
SynthID. To mechanizm cyfrowego znaku wodnego opracowany przez Google DeepMind. Znak wodny jest osadzany bezpośrednio w pikselach obrazu, klatkach wideo, przebiegu audio lub strukturze tekstu wygenerowanego narzędziami Google, i zaprojektowany tak, by przetrwać kompresję, przycinanie czy zmianę rozdzielczości. Od wdrożenia w 2023 roku Google oznaczył nim ponad 20 miliardów wygenerowanych obrazów. Kluczowa zasada interpretacji: wykryty SynthID to dowód, że plik pochodzi z narzędzia Google — ale niewykryty znak wodny to tylko brak sygnału, nigdy dowód autentyczności (mógł zostać usunięty przez silną edycję albo plik po prostu nie powstał w narzędziu Google).
C2PA i Content Credentials. Coalition for Content Provenance and Authenticity (C2PA) to otwarty standard techniczny założony w lutym 2021 roku przez Adobe, Arm, BBC, Intel, Microsoft i Truepic, obecnie wspierany także przez Google, OpenAI, Meta i Amazon — w styczniu 2026 roku standard miał ponad 6000 firm-członków i afiliowanych podmiotów. C2PA dołącza do pliku kryptograficznie podpisany „manifest” zawierający pełną historię: kto stworzył plik, jakim narzędziem, jakie zmiany wprowadzono. Manipulacja plikiem łamie podpis cyfrowy i jest natychmiast wykrywalna. Ograniczenie jest podobne jak przy SynthID: standard poświadcza historię pliku, a nie jego prawdziwość, i można go pominąć, jeśli platforma dystrybucji usuwa metadane.
Warstwa 2: kontekst publikacji
Drugą warstwą jest sprawdzenie, kto, kiedy i w jakim celu opublikował dany materiał — metoda znana profesjonalnym weryfikatorom jako lateral reading (czytanie boczne). Zamiast analizować sam plik w oderwaniu od kontekstu, otwierasz nową kartę i sprawdzasz, czy niezależne, wiarygodne źródła potwierdzają to samo zdarzenie w tym samym czasie i miejscu. Jeśli rzekome nagranie z ważnego wydarzenia nie pojawia się w żadnym renomowanym medium, a krąży wyłącznie na jednym anonimowym koncie — to sygnał ostrzegawczy silniejszy niż jakakolwiek analiza pikseli. Ta warstwa opiera się na tych samych zasadach, które opisaliśmy szerzej w artykule o porównywaniu relacji różnych redakcji tego samego wydarzenia.
Warstwa 3: analiza treści i klasyfikatory automatyczne
Dopiero na końcu — nie na początku — warto sięgnąć po analizę samej treści: charakterystyczne artefakty wizualne (niespójne cienie i odbicia, nielogiczny tekst w tle, zaburzona symetria) oraz automatyczne narzędzia klasyfikujące. Jak pokazało wspomniane badanie Microsoftu, ludzki wzrok jest w tej warstwie zawodny, dlatego to właśnie tutaj największą wartość dodają wyspecjalizowane narzędzia opisane w dalszej części artykułu.
Kontekst prawny: dlaczego to nagle takie ważne w 2026 roku
2 sierpnia 2026 roku wchodzi w życie art. 50 unijnego rozporządzenia o sztucznej inteligencji (AI Act), który nakłada konkretne obowiązki transparentności. Deepfake’i — materiały realistycznie przedstawiające osoby, zdarzenia lub wypowiedzi, które nie miały miejsca — muszą być oznaczane niezależnie od tego, czy twórca miał intencję wprowadzenia kogokolwiek w błąd. Dostawcy generatywnych systemów AI mają obowiązek znakowania treści w sposób odczytywalny maszynowo (z przejściowym okresem dostosowawczym do 2 grudnia 2026 roku dla narzędzi już dostępnych na rynku), a podmioty publikujące treści generowane przez AI na tematy istotne społecznie muszą je oznaczać, chyba że przeszły one rzetelną redakcyjną weryfikację człowieka. Kary za nieprzestrzeganie tych przepisów sięgają 15 milionów euro lub 3% globalnego rocznego obrotu firmy — w zależności od tego, która kwota jest wyższa.
Dla przeciętnego użytkownika internetu oznacza to, że w najbliższych latach coraz więcej treści będzie niosło ze sobą czytelne dla maszyn (choć niekoniecznie dla człowieka) oznaczenia pochodzenia — co czyni znajomość narzędzi odczytujących te oznaczenia (opisanych niżej) praktyczną umiejętnością, nie tylko ciekawostką techniczną.
Narzędzia do weryfikacji treści AI — przegląd praktyczny
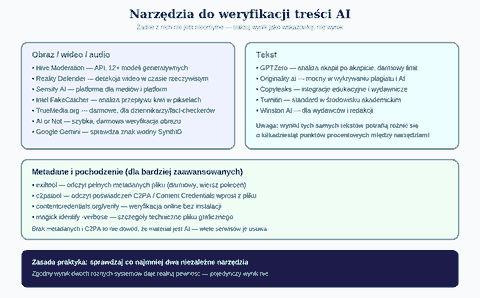
Poniżej zestawienie realnych, działających narzędzi, podzielonych według typu treści. Żadne z nich nie jest nieomylne — niezależne testy pokazują rozbieżności sięgające kilkudziesięciu punktów procentowych między konkurencyjnymi produktami, dlatego kluczowa zasada brzmi: sprawdzaj co najmniej dwoma niezależnymi narzędziami.
Narzędzia do obrazu, wideo i audio
- Hive Moderation — platforma API do moderacji treści, wykorzystywana m.in. przez Reddit i Giphy. Rozpoznaje obrazy wygenerowane przez ponad 12 różnych architektur modeli (Midjourney, DALL-E 3, Stable Diffusion, Flux) i potrafi wskazać, który silnik prawdopodobnie posłużył do stworzenia obrazu.
- Reality Defender — specjalizuje się w wykrywaniu deepfake wideo w czasie rzeczywistym; oferuje rozszerzenie przeglądarkowe do skanowania stron internetowych i lokalnych plików.
- Sensity AI — platforma klasy enterprise dla mediów i dużych platform internetowych, obsługująca duże wolumeny treści.
- Intel FakeCatcher — technicznie najciekawsze rozwiązanie: analizuje sygnał fotopletyzmograficzny, czyli subtelne zmiany koloru skóry wywołane przepływem krwi, których syntetyczne twarze nie odtwarzają wiarygodnie. Dostępne głównie dla partnerów instytucjonalnych.
- TrueMedia.org — darmowe narzędzie tworzone z myślą o dziennikarzach i fact-checkerach.
- AI or Not — szybkie, darmowe narzędzie do wstępnej weryfikacji pojedynczego obrazu lub nagrania audio.
- Google Gemini — aplikacja pozwala sprawdzić obecność znaku wodnego SynthID bezpośrednio w przesłanym pliku.
Narzędzia do tekstu
- GPTZero — najpopularniejszy detektor tekstu AI, oferujący darmowy limit (10 000 słów miesięcznie) oraz analizę na poziomie poszczególnych akapitów. W niezależnych testach z 2026 roku wykazał wysoką skuteczność wykrywania tekstu generowanego przez najnowsze modele, choć wcześniejsze, niezależne testy notowały wyniki znacznie niższe niż deklarowane przez producenta — rozbieżność rzędu kilkudziesięciu punktów procentowych między testami jest w tej branży normą.
- Originality.ai — popularne narzędzie łączące wykrywanie plagiatu i treści AI, silniejsze przy starszych modelach niż przy najnowszych.
- Copyleaks i Turnitin — szeroko stosowane w środowisku akademickim i wydawniczym.
- Winston AI — kierowane głównie do wydawców i redakcji weryfikujących oryginalność tekstu.
Ważne zastrzeżenie: te same teksty, przepuszczone przez różne detektory, potrafią otrzymać skrajnie różne oceny — w niektórych porównaniach rozbieżność sięgała ponad 60 punktów procentowych między narzędziami dla tego samego tekstu. Żaden z tych produktów nie powinien być traktowany jako ostateczny wyrok, zwłaszcza w kontekstach o wysokiej stawce (np. zarzuty o nieuczciwość akademicką).
Narzędzia do odczytu metadanych i pochodzenia
- exiftool — darmowe narzędzie wiersza poleceń do odczytu pełnych metadanych pliku graficznego lub wideo.
- c2patool — oficjalne narzędzie do odczytu poświadczeń C2PA / Content Credentials bezpośrednio z pliku.
- contentcredentials.org/verify — przeglądarkowa wersja weryfikacji Content Credentials, nie wymaga instalacji.
- magick identify -verbose (ImageMagick) — szczegółowa analiza techniczna struktury pliku graficznego.
Dlaczego żadnemu narzędziu nie należy ufać bezkrytycznie
Rynek detektorów AI rośnie w tempie kilkudziesięciu procent rocznie, a wraz z nim rośnie rozrzut jakości. Niezależne testy z 2026 roku pokazują, że deklarowana przez producentów dokładność (często 95–99%) w praktycznych, niezależnych testach bywa znacząco niższa, a wskaźniki fałszywych alarmów (błędne oznaczenie ludzkiej pracy jako AI) wahają się zwykle między 5 a 12%, w zależności od narzędzia i typu treści. Oznacza to, że nawet dobre narzędzie może błędnie oskarżyć autentyczny materiał — dlatego wynik pojedynczego detektora nigdy nie powinien być jedyną podstawą poważnych decyzji (np. odrzucenia pracy studenckiej albo oskarżenia kogoś o publikację fałszywki).
Najbezpieczniejsza praktyka: traktuj każde narzędzie jako jeden głos w większym procesie dowodowym, łącz analizę treści z warstwą pochodzenia i kontekstu, i zawsze szukaj zgodności między co najmniej dwoma niezależnymi źródłami weryfikacji.
Praktyczny protokół krok po kroku
- Zabezpiecz oryginał. Zanim zaczniesz analizę, zapisz plik w oryginalnej jakości — zrzuty ekranu czy skompresowane kopie tracą metadane i utrudniają dalszą weryfikację.
- Sprawdź metadane i C2PA narzędziem takim jak exiftool lub c2patool / contentcredentials.org.
- Sprawdź znak wodny, jeśli podejrzewasz narzędzia Google — poprzez aplikację Gemini.
- Zastosuj lateral reading — sprawdź, czy niezależne, wiarygodne źródła potwierdzają ten sam materiał lub zdarzenie.
- Uruchom co najmniej dwa niezależne klasyfikatory (np. jeden do obrazu, jeden do tekstu, albo dwa konkurencyjne narzędzia tego samego typu) i porównaj wyniki.
- Wyciągnij wniosek proporcjonalny do dowodów. Zgodny wynik trzech warstw daje wysoką pewność; sprzeczne lub niejednoznaczne sygnały uzasadniają wyłącznie ostrożny wniosek, nie kategoryczne twierdzenie.
Najczęściej zadawane pytania
Czy istnieje jedno narzędzie, które rozpozna każdy rodzaj treści AI?
Nie. Wykrywanie obrazu, wideo, audio i tekstu to odrębne problemy techniczne, rozwiązywane różnymi metodami. Nawet duże platformy typu Hive czy Reality Defender łączą wiele wyspecjalizowanych modeli pod jednym interfejsem, zamiast polegać na jednym uniwersalnym algorytmie.
Czy brak oznaczenia AI Act oznacza, że materiał na pewno nie jest generowany przez AI?
Nie. Obowiązek oznaczania wchodzi w życie stopniowo (od sierpnia i grudnia 2026 roku) i dotyczy głównie dostawców i podmiotów działających na terenie UE — twórcy spoza UE lub działający niezgodnie z prawem nie zawsze będą go respektować.
Czy warto ufać wynikowi w 99%, jaki podaje detektor?
Traktuj deklarowaną przez producenta dokładność z ograniczonym zaufaniem — niezależne testy regularnie pokazują wyniki znacząco odbiegające od materiałów marketingowych. Liczy się przede wszystkim zgodność wyników z innych, niezależnych źródeł weryfikacji.
Podsumowanie
Wykrywanie treści generowanych przez AI w 2026 roku to już nie kwestia wyćwiczonego oka, tylko systematycznego procesu opartego na trzech uzupełniających się warstwach: technicznym pochodzeniu pliku (metadane, SynthID, C2PA), kontekście publikacji (lateral reading) oraz — dopiero na końcu — analizie treści wspomaganej wyspecjalizowanymi narzędziami. Żadna pojedyncza metoda, w tym żaden komercyjny detektor, nie daje stuprocentowej pewności. Nadchodzące przepisy unijnego AI Act zmienią krajobraz oznaczania treści, ale odpowiedzialność za krytyczną weryfikację tego, co widzimy w sieci, pozostanie — jak dotąd — po stronie odbiorcy.