Wpisujecie z koleżanką dokładnie to samo zapytanie w Google, siedząc obok siebie — i widzicie różne wyniki. Brzmi znajomo? To jedno z najczęściej powtarzanych przekonań o internecie: że Google „wie”, kim jesteś, i pokazuje każdemu inną, dopasowaną do niego rzeczywistość. Prawda jest bardziej skomplikowana — i, jak się okazuje, jest przedmiotem realnego sporu między samym Google a jego konkurentami.
W tym artykule rozkładam personalizację wyszukiwania na czynniki pierwsze: skąd wziął się mit „bańki filtrującej”, co Google oficjalnie mówi o własnych mechanizmach personalizacji, jak wyglądał głośny spór z DuckDuckGo z 2018 roku, oraz — jako że warto zrozumieć to również od strony technicznej — jak infrastruktura wyszukiwarki na poziomie inżynierskim odpowiada za różnice, które mylnie przypisujemy personalizacji.
Skąd wziął się mit „bańki filtrującej”
Termin filter bubble (bańka filtrująca) wprowadził do powszechnego użycia amerykański aktywista i przedsiębiorca Eli Pariser w swojej książce „The Filter Bubble: What the Internet Is Hiding from You” z 2011 roku, a spopularyzował go w tym samym roku w słynnym wystąpieniu na TED. Pariser opisał w niej anegdotę, która stała się punktem wyjścia całej debaty: poprosił dwie znajome — o zbliżonym profilu społecznym i wykształceniu — o wyszukanie hasła „BP” w czasie wycieku ropy z platformy Deepwater Horizon w Zatoce Meksykańskiej. Jedna zobaczyła głównie wyniki inwestycyjne dotyczące spółki BP, druga — wyniki dotyczące katastrofy ekologicznej.
Teza Parisera brzmiała: algorytmy personalizujące treść (nie tylko w Google, ale też na Facebooku) stopniowo zamykają użytkowników w informacyjnych „bańkach”, pokazując coraz więcej tego, co już potwierdza ich poglądy, a coraz mniej tego, co mogłoby je skonfrontować z odmiennym punktem widzenia.
To ważna i wpływowa teoria — ale, jak zobaczysz w dalszej części artykułu, jej empiryczne potwierdzenie jest znacznie słabsze, niż sugeruje jej popularność.
Spór o fakty: DuckDuckGo kontra Google (2018)
Najbardziej konkretnym, przywoływanym do dziś testem tej teorii jest badanie przeprowadzone w czerwcu 2018 roku przez DuckDuckGo — konkurencyjną wobec Google wyszukiwarkę, która swoją markę buduje na braku śledzenia użytkowników. 87 uczestników w USA wyszukiwało jednocześnie te same trzy hasła — „gun control” (kontrola broni), „immigration” (imigracja) i „vaccinations” (szczepienia) — zarówno w trybie incognito, jak i w zwykłym, zalogowanym oknie przeglądarki.
Wyniki DuckDuckGo przedstawiło jako dowód na istnienie bańki filtrującej: większość uczestników widziała unikalne dla siebie zestawy wyników, a różnice utrzymywały się nawet w trybie incognito i po wylogowaniu — od 57% (dla „immigration”) do aż 92% (dla „vaccinations”) uczestników zobaczyło spersonalizowane wyniki nawet w trybie prywatnym. Największe różnice DuckDuckGo odnotowało w blokach wiadomości i wideo.
Google odpowiedziało na te wyniki wprost i publicznie. Danny Sullivan, oficjalny rzecznik Google ds. wyszukiwarki (Search Liaison), napisał serię wiadomości, w których nazwał ideę silnej personalizacji „mitem”. Według Sullivana różnice w wynikach dla tego samego zapytania wynikają zwykle z przyczyn niezwiązanych z personalizacją: lokalizacji, ustawień języka, platformy oraz — co szczególnie istotne z technicznego punktu widzenia — dynamicznej, rozproszonej natury samego systemu wyszukiwania. Sullivan zaznaczył też wprost: „Nie personalizujemy wyników wyszukiwania na podstawie profili demograficznych ani nie tworzymy takich profili do użytku w Google Search”.

Co Google oficjalnie mówi o personalizacji
Zgodnie z oficjalną dokumentacją Google Search Help, prawdziwa personalizacja oparta na koncie i historii aktywności jest w praktyce ograniczona do kilku konkretnych sytuacji:
- Zapytania niejednoznaczne — jeśli szukasz encji o niejasnej nazwie (klasyczny przykład podawany przez Google to „apple” — owoc czy firma technologiczna), Twoja wcześniejsza historia wyszukiwań związana z tym hasłem może wpłynąć na kolejność wyników.
- Kolejność, nie treść — personalizacja najczęściej zmienia kolejność już wyselekcjonowanych wyników, a nie sam ich zestaw. Czasem zmienia też kolejność bloków treści — jeśli zwykle oglądasz filmy, wideo mogą pojawić się wyżej niż strony internetowe.
- Funkcje rekomendacyjne — spersonalizowane są przede wszystkim funkcje typu Discover, rekomendacje „co obejrzeć” czy sugestie wydarzeń — nie podstawowe wyniki wyszukiwania.
- Karuzela wiadomości nigdy nie jest personalizowana — to jedno z niewielu miejsc, gdzie Google wprost deklaruje zerowy wpływ personalizacji.
Kontrolę nad tym mechanizmem znajdziesz w ustawieniach „Web & App Activity” oraz „Personalized Recommendations” w Twoim koncie Google — możesz je wyłączyć w dowolnym momencie, choć samo wyłączenie nie usuwa już zapisanej historii (trzeba to zrobić osobno).
Ile w tym prawdy — spojrzenie akademickie
Tu robi się interesująco: mimo że koncepcja bańki filtrującej jest niezwykle popularna w debacie publicznej (bywa przywoływana jako jedno z wyjaśnień Brexitu czy polaryzacji politycznej w USA), przeglądy literatury naukowej wskazują, że jej empiryczne dowody są dużo słabsze, niż mogłoby się wydawać. Według analizy opublikowanej w Internet Policy Review, badania empiryczne nad bańkami filtrującymi i pokrewnym zjawiskiem „komór echa” (echo chambers) generalnie nie potwierdzają silnej wersji tej tezy — użytkownicy wyszukiwarek i mediów społecznościowych zazwyczaj mają dostęp do dość zróżnicowanej, wyśrodkowanej treści, często bardziej zróżnicowanej niż osoby niekorzystające z tych narzędzi.
To nie znaczy, że personalizacja nie istnieje — pokazuje raczej, że rzeczywistość jest bardziej niuansowa niż popularne hasło sugeruje: różnice w wynikach są realne i częste, ale ich głównym źródłem rzadziej jest wyrafinowany profil psychologiczny użytkownika, a częściej dużo bardziej przyziemne czynniki techniczne.
Okiem inżyniera: dlaczego wyszukiwarka z natury nie może dać wszystkim identycznych wyników
Ta sekcja to spojrzenie na problem od strony architektury systemu wyszukiwania — dokładnie tak, jak tłumaczyłby to inżynier pracujący nad infrastrukturą wyszukiwarki.
1. Wyszukiwarka to nie jedna baza danych, tylko tysiące rozproszonych kopii. Indeks Google — czyli baza wszystkich znanych stron internetowych — jest zbyt duży, by trzymać go w jednym miejscu. Jest replikowany w wielu centrach danych na całym świecie, a każde z nich aktualizuje się z osobnym opóźnieniem. Gdy Twoje zapytanie trafia do centrum danych w Warszawie, a zapytanie znajomego — do centrum we Frankfurcie, możecie dostać nieznacznie inne wyniki tylko dlatego, że jedno centrum otrzymało najnowszą aktualizację indeksu kilka minut wcześniej niż drugie. To zjawisko Google wprost przywołało jako jedną z głównych, niepersonalizowanych przyczyn różnic w odpowiedzi na badanie DuckDuckGo.
2. Ranking to wynik dziesiątek niezależnych systemów, nie jednego algorytmu. To, co potocznie nazywamy „algorytmem Google”, to w rzeczywistości zestaw wielu wyspecjalizowanych systemów rankingowych (rozumienie zapytania, ocena jakości strony, systemy wykrywania spamu, systemy lokalne, systemy „świeżości” wyników) działających warstwowo. Nowe wersje tych systemów są wdrażane stopniowo, często metodą stopniowego wprowadzania (ang. staged rollout) na wybranym procencie ruchu — dlatego dwie osoby mogą trafić na różne wersje rankingu tego samego zapytania, mimo że żadna z nich nie jest „spersonalizowana” w sensie profilu użytkownika.
3. Kontekst zapytania jest przetwarzany zawsze — nawet bez konta. Adres IP (a więc przybliżona lokalizacja), nagłówek języka przeglądarki, typ urządzenia i pora dnia to sygnały przetwarzane dla każdego zapytania, zalogowanego czy nie. Z technicznego punktu widzenia to nie jest „personalizacja” w sensie profilu behawioralnego — to kontekstualizacja zapytania, konieczna, żeby wynik w ogóle był użyteczny (inaczej każde zapytanie „pizza blisko mnie” zwracałoby te same restauracje wszystkim ludziom na świecie).
4. Prawdziwa personalizacja behawioralna to osobna, dużo mniejsza warstwa. Sygnał historii wyszukiwania jest doklejany na samym końcu potoku przetwarzania zapytania — zwykle jako dodatkowy czynnik przy re-rankingu już gotowej listy wyników, a nie jako wejście do głównego systemu selekcji treści. To architektonicznie tłumaczy, dlaczego wpływ historii konta jest, zgodnie z deklaracjami Google, ograniczony głównie do kolejności, a nie do zestawu wyników.
Jak samodzielnie sprawdzić, co wpływa na Twoje wyniki
Zamiast zakładać, że różnica w wynikach to od razu „bańka filtrująca”, warto podejść do tego metodycznie — podobnie jak przy weryfikacji każdej innej informacji w sieci.
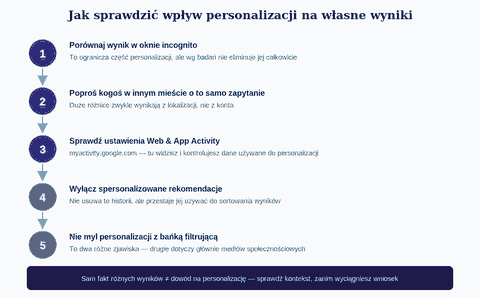
Krok 1: Porównaj wynik w oknie incognito
To dobry pierwszy test, choć — jak pokazało badanie DuckDuckGo — nie eliminuje personalizacji całkowicie, ponieważ kontekst (lokalizacja, język, urządzenie) i tak jest przetwarzany.
Krok 2: Poproś kogoś z innego miasta o to samo zapytanie
Jeśli różnice są duże, w wielu przypadkach to lokalizacja, a nie konto, odpowiada za większość rozbieżności — szczególnie przy zapytaniach lokalnych lub newsowych.
Krok 3: Sprawdź swoje ustawienia Web & App Activity
Na stronie myactivity.google.com możesz zobaczyć dokładnie, jakie dane są zbierane i wykorzystywane do personalizacji, a także wyłączyć poszczególne kategorie.
Krok 4: Wyłącz spersonalizowane rekomendacje
To nie usuwa zapisanej historii, ale przestaje jej używać do sortowania przyszłych wyników — dobry sposób na oddzielenie efektu personalizacji od efektu kontekstu.
Krok 5: Nie myl personalizacji wyszukiwania z bańką filtrującą w mediach społecznościowych
To dwa różne, choć często mylone zjawiska. Algorytmy rekomendacji treści w mediach społecznościowych (feed, „dla Ciebie”) działają na zupełnie innych zasadach i mają znacznie silniejszy udokumentowany wpływ na to, co widzisz, niż klasyczne wyszukiwanie w Google.
Najczęściej zadawane pytania
Czy dwie osoby wyszukujące to samo hasło zawsze zobaczą identyczne wyniki?
Nie, i to normalne. Lokalizacja, język, urządzenie, pora dnia oraz stan aktualizacji poszczególnych centrów danych wystarczą, by wygenerować różnice — bez żadnej personalizacji opartej na koncie.
Czy wylogowanie się z konta Google gwarantuje „neutralne” wyniki?
Nie do końca. Badanie DuckDuckGo wykazało, że różnice utrzymują się nawet w trybie incognito i po wylogowaniu — bo kontekst (lokalizacja, urządzenie) nadal jest przetwarzany niezależnie od stanu konta.
Czy istnienie różnic w wynikach potwierdza teorię bańki filtrującej?
Niekoniecznie. Różnice w wynikach są udokumentowanym faktem, ale przeglądy badań akademickich wskazują, że silna wersja tezy o bańce filtrującej — czyli stopniowe, systematyczne izolowanie użytkownika od odmiennych poglądów — ma znacznie słabsze wsparcie empiryczne, niż sugeruje jej popularność w debacie publicznej.
Podsumowanie
Różne wyniki dla tego samego zapytania to fakt, ale przyczyna rzadko jest tak dramatyczna, jak sugeruje popularny mit „bańki filtrującej”. Realny obraz, potwierdzony zarówno przez oficjalne stanowisko Google, jak i przeglądy badań akademickich, jest bardziej przyziemny: w grę wchodzi architektura rozproszonego systemu wyszukiwania, kontekst zapytania (lokalizacja, język, urządzenie) i dopiero na końcu — stosunkowo ograniczona personalizacja oparta na koncie. Zrozumienie tej różnicy to nie tylko ciekawostka techniczna — to konkretne narzędzie, które pozwala trafniej ocenić, czy to, co widzisz w wynikach wyszukiwania, mówi więcej o świecie, czy tylko o Twoich ostatnich kliknięciach.
Chcesz pogłębić temat?
Jeśli podoba Ci się to, jak piszemy o wyszukiwaniu i weryfikacji informacji, oto jak możesz pójść krok dalej:
- 📘 Sięgnij po nasz poradnik — kompletny przewodnik po skutecznym wyszukiwaniu i ocenie informacji: kup poradnik „Jak szukać?”
- 💛 Wesprzyj rozwój bloga na Suppi — każda złotówka pomaga nam tworzyć więcej takich materiałów: wesprzyj nas na Suppi
- 🎥 Odwiedź nasz kanał na YouTube — tam tłumaczymy te same tematy w formie wideo: zobacz nasz YouTube